
خروجی رگرسیون خطی در SPSS معمولاً چند جدول مرتب تحویل میدهد؛ اما وجود ستون Sig. به این معنی نیست که مدل، سؤال پژوهش را درست پاسخ داده است. ممکن است پیامد و پیشبینها نامناسب تعریف شده باشند، چند مشاهده بر نتیجه مسلط شده باشند یا دادههای تکراری بهاشتباه مستقل فرض شوند. این راهنما مسیر ساختن، بررسی و گزارش یک مدل خطی را توضیح میدهد؛ اعداد مثالها فرضیاند و توصیه درمانی محسوب نمیشوند.
رگرسیون خطی چه سؤالی را پاسخ میدهد؟
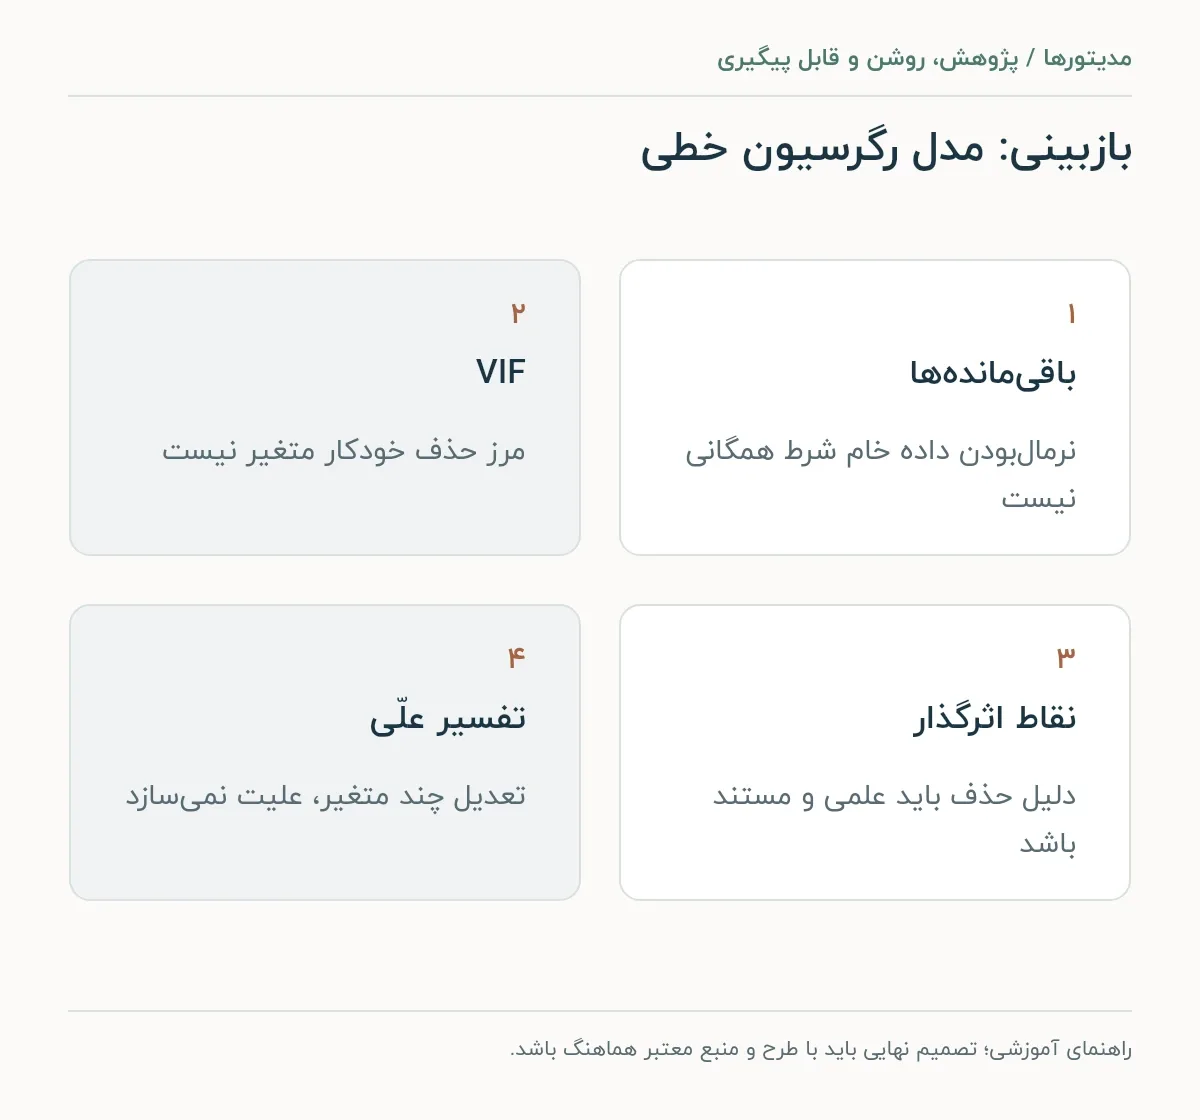
در مدل معمول، میانگین یک پیامد کمی برحسب یک یا چند متغیر توضیح داده میشود. مثلاً میتوان پرسید در یک نمونه پژوهشی، میانگین نمره کیفیت زندگی با ساعات خواب چه ارتباطی دارد، وقتی سن و یک عامل زمینهای مشخص ثابت نگه داشته شوند. این «ثابت نگه داشتن» محاسباتی است؛ افراد واقعاً تصادفی تخصیص نیافتهاند و صرف اضافهکردن چند متغیر، رابطه را علّی نمیکند.
پیش از بازکردن نرمافزار، واحد مشاهده را مشخص کنید: بیمار، مراجعه یا مرکز؟ اگر هر بیمار چند ردیف دارد، مدل ساده با خطاهای مستقل معمولاً کافی نیست. پیامد صفر و یک نیز بهطور پیشفرض مسئله رگرسیون خطی معمول نیست؛ برای آن باید مدل و هدف مناسب دیگری انتخاب شود. راهنمای انتخاب آزمون آماری پایاننامه نقطه شروع خوبی برای این تصمیم است.
پیش از اجرا؛ داده و کدگذاری را کنترل کنید
- دامنه و واحد تمام متغیرها را بنویسید؛ یک ضریب «به ازای یک سال» با ضریب «به ازای ده سال» متفاوت است.
- برای متغیرهای طبقهای، گروه مرجع و متغیرهای نشانگر را روشن تعریف کنید. کدهای ۱، ۲ و ۳ لزوماً فاصله عددی معنادار ندارند.
- کدهایی مانند ۹۹۹ را بهعنوان داده گمشده تعریف کنید؛ باقیماندن آنها میتواند مدل را منحرف کند.
- دلیل ورود پیشبینها را از سؤال و دانش موضوعی تعیین کنید؛ انتخاب خودکار صرفاً براساس P-value جای طراحی تحلیل را نمیگیرد.
- تعداد افراد وارد تحلیل و الگوی حذف ناشی از داده گمشده را ثبت کنید.
نسخه خام را تغییر ندهید و پاکسازی را در فایل یا دستورهای جدا ثبت کنید. در آمادهسازی داده برای SPSS و مدیریت دادههای گمشده این مرحله با جزئیات بیشتری بررسی شده است.
مسیر اجرای مدل در SPSS
در نسخههای متداول دسکتاپ، از مسیر Analyze → Regression → Linear استفاده میشود. پیامد را در Dependent و پیشبینها را در Independent قرار دهید. نام دقیق گزینهها ممکن است با نسخه و مجوز نصب تفاوت داشته باشد. روش Enter برای واردکردن مجموعه ازپیشتعیینشده متغیرها مناسب است؛ روشهای گامبهگام خودکار نیازمند توجیه و توجه به ناپایداری انتخاب هستند.
در Statistics، برآورد ضرایب، فاصله اطمینان و تشخیص همخطی را درخواست کنید. در Plots، باقیمانده استانداردشده را در برابر مقدار پیشبینیشده استانداردشده قرار دهید؛ نمودار احتمال نرمال نیز برای بررسی توزیع باقیماندهها مفید است. ذخیره مقدار پیشبینیشده، باقیمانده و شاخصهای اثرگذاری به بازبینی بعدی کمک میکند. همراه خروجی، Syntax اجرای نهایی را نگه دارید تا تحلیل قابل تکرار باشد.
جدول ضرایب را چگونه بخوانیم؟
فرض کنید در یک مدل آموزشی، ضریب غیراستاندارد ساعات خواب برابر ۲ باشد. تفسیر درست آن این است که با افزایش یک ساعت خواب، میانگین پیشبینیشده پیامد ۲ واحد بیشتر است، با ثابت بودن سایر متغیرهای واردشده در همان مدل. این جمله به معنی اثبات اثر افزایش خواب یا قابل تعمیم بودن نتیجه به تمام بیماران نیست.
| جزء | کاربرد | احتیاط |
|---|---|---|
| B و فاصله اطمینان | اندازه ارتباط در واحد واقعی پیامد | واحد پیشبین و گروه مرجع باید معلوم باشند |
| Beta استانداردشده | بیان ضریب در مقیاس انحراف معیار | معیار قطعی اهمیت علمی یا علیت نیست |
| R² و R² تعدیلشده | خلاصه برازش در داده تحلیلشده | برازش بالا، اعتبار خارجی را تضمین نمیکند |
| P-value | سازگاری داده با فرض صفر، تحت مدل | اندازه اثر و اهمیت بالینی را نشان نمیدهد |
عرض از مبدأ ممکن است برای ترکیب سن صفر و سایر متغیرهای صفر معنا نداشته باشد. مرکزکردن یک پیشبین حول مقدار معنادار میتواند تفسیر را بهتر کند، ولی نباید برای تغییر دلخواه معناداری به کار رود. اگر تعامل یا جمله درجه دوم دارید، تفسیر ضریب منفرد باید با ساختار کامل مدل هماهنگ شود.
فرضها را روی چه چیزی بررسی کنیم؟
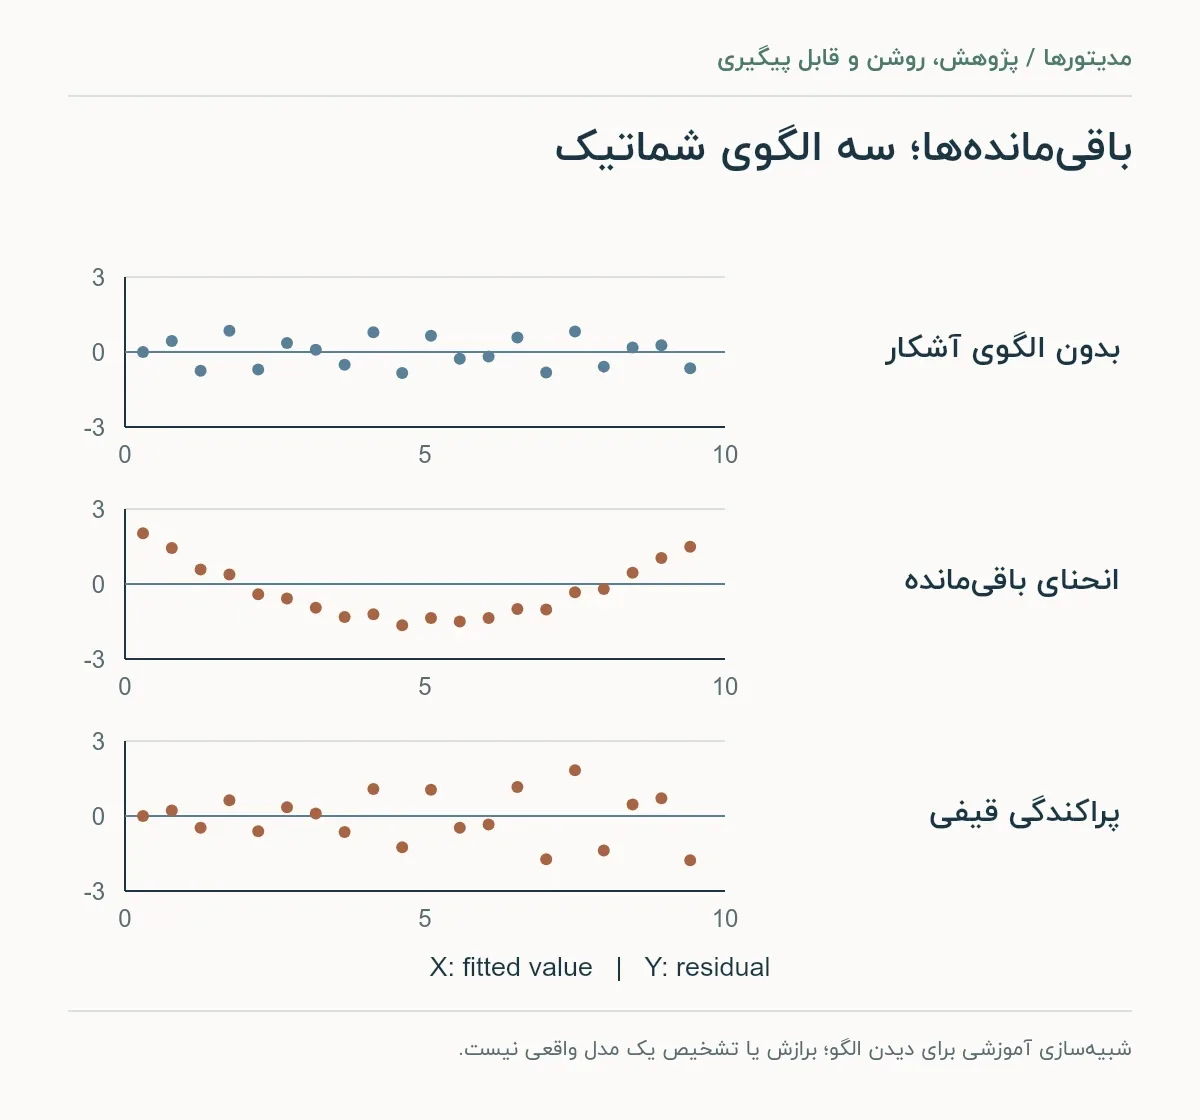
تصور رایج این است که تمام متغیرهای رگرسیون باید نرمال باشند. در واقع، برای استنباط کلاسیک، رفتار خطاها و باقیماندهها و کفایت شکل مدل اهمیت دارد؛ نرمال نبودن خام یک پیشبین بهتنهایی دلیل رد مدل نیست. نمودار باقیمانده در برابر مقدار برازششده را برای انحنا، شکل قیفی و نقاط غیرعادی بررسی کنید. نمودار Q–Q میتواند انحرافهای توزیعی را نشان دهد، ولی یک آزمون نرمالبودن منفرد تصمیمگیر نهایی نیست.
اگر پراکندگی باقیماندهها با مقدار پیشبینی تغییر کند، خطاهای استاندارد معمول ممکن است مناسب نباشند. انتخاب خطای استاندارد مقاوم، تبدیل متغیر یا مدل دیگر باید با هدف تحلیل و امکانات نسخه نرمافزار هماهنگ باشد. وجود خوشهبندی، مثل بیماران داخل بیمارستانها، نیز با «اصلاح نرمالبودن» حل نمیشود؛ ساختار وابستگی باید در روش تحلیل دیده شود.
VIF چیست و چه چیزی را اثبات نمیکند؟
VIF نشان میدهد وابستگی یک پیشبین به سایر پیشبینها چقدر واریانس برآورد ضریب آن را افزایش میدهد. برای یک پیشبین، اگر R² حاصل از رگرسیون آن بر سایر پیشبینها ۰٫۸ باشد، VIF برابر ۵ است؛ اگر R² برابر ۰٫۹ باشد، VIF برابر ۱۰ میشود. اینها محاسبهاند، نه مرزهای قطعی حذف متغیر.
VIF_j = 1 / (1 - R_j²)
R_j² = 0.80 → VIF = 5
R_j² = 0.90 → VIF = 10
تصمیم حذف باید نقش علمی متغیر، اندازه نمونه، فاصلههای اطمینان و هدف برآورد را در نظر بگیرد. حذف یک مخدوشگر ضروری صرفاً برای پایینآوردن VIF ممکن است برآورد را بدتر کند. متغیرهای مشتقشده از یکدیگر، مجموع و اجزای همان مجموع، و کدگذاری نادرست طبقات را نیز بررسی کنید.
با نقاط پرت و اثرگذار چه کنیم؟
ابتدا خطای ورود، واحد اشتباه و رکورد تکراری را بررسی کنید. اگر داده واقعی است، حذف آن صرفاً برای بهترشدن P-value پذیرفتنی نیست. باقیمانده بزرگ، اهرم بالا و اثرگذاری مفاهیم یکسانی نیستند؛ شاخصهایی مانند Cook’s distance باید همراه نمودار و زمینه مطالعه تفسیر شوند. تحلیل حساسیت با و بدون مشاهده، در صورت توجیه، میتواند میزان وابستگی نتیجه را نشان دهد؛ روش و دلیل آن باید گزارش شود.
چکلیست گزارش پایاننامه
- پیامد، پیشبینها، گروههای مرجع و روش انتخاب مدل را توضیح دهید.
- تعداد تحلیلشده و شیوه برخورد با داده گمشده را بنویسید.
- ضرایب، فاصله اطمینان، معیار برازش و بررسیهای تشخیصی مهم را ارائه کنید.
- نقض فرضها و اقدام واقعی انجامشده را گزارش کنید؛ عبارت کلی «تمام فرضها برقرار بود» کافی نیست.
- ارتباط تعدیلشده را با اثر علّی اشتباه نگیرید و محدودیت تعمیم را توضیح دهید.
برای طراحی مدل و بازبینی خروجی میتوانید از مشاوره آنالیز آماری استفاده کنید. اگر نقش متغیرهای کنترلی روشن نیست، ابتدا تفاوت مخدوشگر، میانجی و تعدیلگر را بخوانید.
منابع و مطالعه بیشتر
- UCLA: تشخیصهای رگرسیون در SPSS؛ نمودارها، همخطی و نقاط اثرگذار.
- UCLA: انتخاب تحلیل با توجه به نوع متغیرها.
بازبینی محتوایی: ۱۳ آبان ۱۴۰۵. تصویر اصلی، ترکیببندی مفهومی اختصاصی است؛ نمودارها و مثالهای عددی آموزشیاند و داده واقعی پژوهش یا تصویر مستند یک مؤسسه معرفی نشدهاند.


