
وجود داده گمشده در پایاننامه لزوماً به معنی خرابشدن پژوهش نیست، اما تصمیم عجولانه درباره آن میتواند نتیجه را تغییر دهد. حذف همه افراد ناقص، جایگزینی با میانگین یا واردکردن صفر برای سلول خالی، پاسخ عمومی مناسبی نیست. ابتدا باید بدانید کدام داده، برای چه کسانی و به چه علتی ثبت نشده است.
در این راهنما، مسیر بررسی دادههای ناقص را از ممیزی فایل تا انتخاب روش تحلیل مرور میکنیم. هدف این است که با یک گزارش روشن به مشاور آمار برسید و بتوانید تصمیم نهایی را در پایاننامه توضیح دهید؛ روش مناسب برای هر طرح باید با توجه به سؤال و مفروضات انتخاب شود.
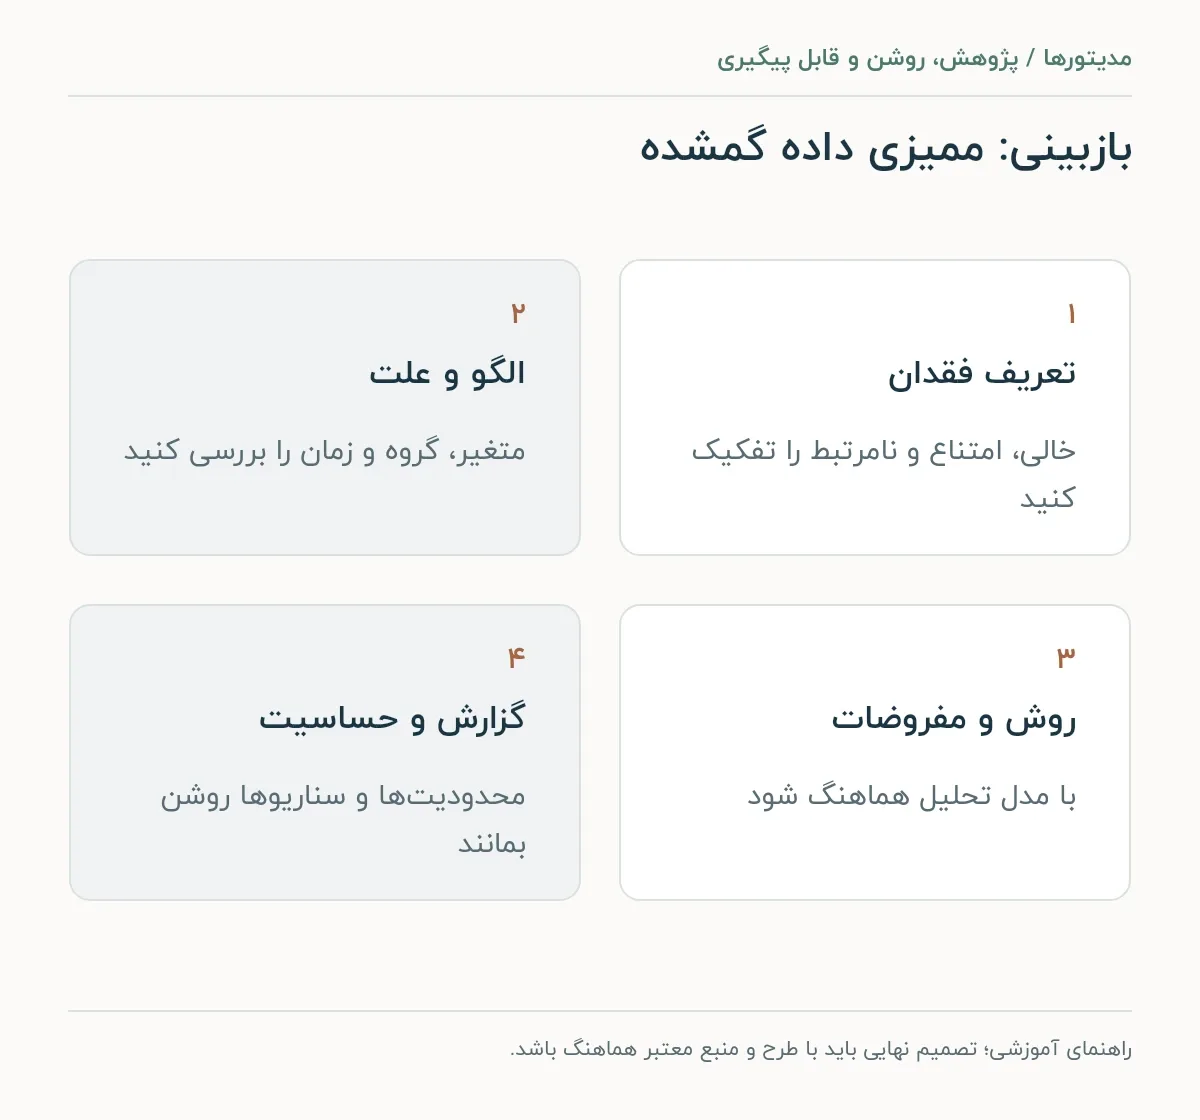
پیش از هر تحلیل، «گمشده» را تعریف کنید
یک سلول خالی میتواند به معنی فراموششدن ثبت، امتناع پاسخدهنده، قابل اجرا نبودن سؤال یا از دست رفتن پیگیری باشد. این وضعیتها یکسان نیستند. اگر از کدهایی مانند ۹۹۹ یا منفی یک استفاده کردهاید، فرهنگ داده باید معنای آنها را روشن کند. عدد کدگذاریشده تا زمانی که به نرمافزار معرفی نشده، ممکن است یک مقدار واقعی تلقی شود.
در SPSS، داده گمشده سیستمی با دادهای که کاربر بهعنوان گمشده تعریف میکند تفاوت دارد. رفتار دستورها نیز ممکن است متفاوت باشد. مستندات آموزشی UCLA نمونههای این تفاوت را نشان میدهد. راهنمای داده گمشده در SPSS
نسخه خام را دستنخورده نگه دارید و پاکسازی را روی نسخه جدا و با ثبت دستورها انجام دهید. راهنمای آمادهسازی فایل داده پایاننامه به ساخت شناسه، فرهنگ داده و کنترل مقدارهای نامعتبر کمک میکند.

اول میزان و الگوی فقدان داده را گزارش کنید
فقط نگویید «چند داده ناقص بود». برای هر متغیر، تعداد مورد انتظار، تعداد موجود و درصد گمشده را محاسبه کنید. سپس ببینید آیا همان افراد در چند متغیر داده ندارند یا فقدان داده بین افراد پراکنده است. این بررسی را برای گروههای مطالعه و زمانهای پیگیری هم انجام دهید.
| متغیر یا مجموعه | موجود | گمشده | پرسش پیگیری |
|---|---|---|---|
| نمره پیش از مداخله | ۹۶ | ۴ | چهار مورد چرا ثبت نشدهاند؟ |
| نمره پس از مداخله | ۸۴ | ۱۶ | آیا علت فقدان بین گروهها متفاوت است؟ |
| هر دو نمره در یک فرد | ۸۲ | ۱۸ فرد فاقد جفت کامل | تحلیل مورد کامل چه کسانی را کنار میگذارد؟ |
این مثال فرضی نشان میدهد حتی وقتی هر متغیر جداگانه داده نسبتاً زیادی دارد، تعداد افراد دارای تمام متغیرهای لازم میتواند کمتر شود. مخرج هر تحلیل را شفاف گزارش کنید. «صد نفر وارد مطالعه شدند» الزاماً به معنی «صد نفر در تمام مدلها تحلیل شدند» نیست.
MCAR، MAR و MNAR به زبان ساده
- MCAR: در چارچوب مدل، فقدان داده به مقادیر مشاهدهشده یا مشاهدهنشده وابسته نیست. گمشدن تصادفی تعدادی برگه، اگر واقعاً مستقل از ویژگی افراد باشد، میتواند مثالی فرضی باشد.
- MAR: پس از درنظرگرفتن متغیرهای مشاهدهشده مرتبط، احتمال فقدان به مقدار گمشده وابسته نیست. مثلاً فقدان پیگیری با سن ثبتشده ارتباط دارد و سن در مدل مناسب لحاظ میشود.
- MNAR: حتی پس از توجه به اطلاعات مشاهدهشده، احتمال فقدان به مقدار مشاهدهنشده وابسته میماند؛ مانند احتمال پاسخندادن بیشتر در کسانی که شدتِ ثبتنشده پیامدشان بالاتر است.
اینها مفروضات درباره سازوکار فقداناند، نه برچسبهایی که همیشه با یک آزمون قطعی تعیین شوند. غیرمعنادارشدن یک آزمون، MAR را اثبات نمیکند و از خود دادههای مشاهدهشده معمولاً نمیتوان MAR و MNAR را قطعی از هم جدا کرد. شناخت فرایند جمعآوری و تحلیل حساسیت اهمیت دارد. راهنمای روششناسی استرن و همکاران درباره داده گمشده
روشها چه تفاوتی دارند؟
| روش | چه میکند؟ | محدودیت مهم |
|---|---|---|
| تحلیل موارد کامل | فقط افراد کامل برای متغیرهای همان تحلیل را نگه میدارد | کاهش دقت و احتمال سوگیری، وابسته به سازوکار و مدل |
| جایگزینی تکمقداری | یک مقدار مانند میانگین را در خانههای خالی میگذارد | معمولاً عدم قطعیت را درست منعکس نمیکند و روابط را تغییر میدهد |
| روشهای مبتنی بر مدل | از اطلاعات موجود با مفروضات مشخص استفاده میکند | به مدل درست و شرایط سازگار نیاز دارد |
| برآورد چندگانه | چند مجموعه تکمیلشده میسازد و نتایج را ترکیب میکند | نیازمند طراحی مدل تکمیل، بررسی تشخیصها و مفروضات است |
| تحلیل حساسیت | نتیجه را زیر مفروضات جایگزین بررسی میکند | سناریوها باید معنادار، شفاف و مرتبط با مطالعه باشند |
هیچ درصد واحدی از داده گمشده، بهتنهایی روش مناسب را تعیین نمیکند. گمشدن چند مورد در پیامد اصلی یا یک زیرگروه مهم میتواند از فقدان بیشتر در متغیری فرعی اثر متفاوتی داشته باشد. تصمیم را فقط با قواعدی مثل «کمتر از پنج درصد حذف شود» نگیرید.
برآورد چندگانه چه میکند و چه نمیکند؟
در برآورد چندگانه، داده گمشده یک بار با یک عدد ظاهراً قطعی پر نمیشود؛ چند مجموعه داده متناسب با مدل ساخته میشود، تحلیل در هرکدام انجام میگیرد و برآوردها با توجه به عدم قطعیت ترکیب میشوند. تعداد مجموعهها، متغیرهای واردشده و مدل هر نوع متغیر باید آگاهانه تعیین شوند.
مدل تکمیل باید با تحلیل اصلی و ساختار داده سازگار باشد؛ از جمله روابط مهم، پیامد، متغیرهای کمکی و در صورت لزوم خوشهبندی یا زمان. شناسه فرد یا وضعیتی که «بهطور ساختاری نامربوط» است را مانند یک اندازهگیری گمشده معمولی پر نکنید. برآورد چندگانه مقدار واقعی ازدسترفته را کشف نمیکند و بهتنهایی مشکل MNAR را حل نمیکند. آموزش دانشگاهی فرایند برآورد چندگانه
در SPSS از کجا شروع کنیم؟
ابتدا با فراوانی و آمار توصیفی، دامنه و کدهای غیرعادی را بررسی کنید. اگر برای دو نمره، ۹۹۹ به معنی «ثبت نشده» است، دستور آموزشی زیر میتواند آن را بهعنوان گمشده تعریف کند. نام متغیرها و کدها را مطابق فرهنگ داده خود تغییر دهید و روی فایل اصلی اجرا نکنید:
* Hypothetical variables; 999 means missing, not a valid score.
MISSING VALUES score_pre score_post (999).
FREQUENCIES VARIABLES=score_pre score_post.
این دستور داده را برآورد نمیکند؛ فقط به نرمافزار میگوید یک کد خاص، مقدار معتبر نیست. خروجی را با جدول دستی چند مشاهده تطبیق دهید. دسترسی به امکانات تحلیل فقدان یا برآورد چندگانه ممکن است به نسخه و مجوز SPSS بستگی داشته باشد؛ وجود یک منو، مجوز انتخاب روش بدون طراحی آماری نیست.
پیشگیری از فقدان داده بخشی از طراحی است
فرم کوتاه و روشن، آموزش تیم، کنترل زودهنگام فایلها و برنامه پیگیری میتواند فقدان قابل پیشگیری را کاهش دهد. اجبار پاسخ به سؤال حساس یا فشار به شرکتکننده، راهحل اخلاقی نیست. علت ناتمامماندن را، تا حدی که مجاز و ممکن است، با کدهای مشخص ثبت کنید؛ «امتناع»، «عدم دسترسی» و «نامرتبط» را در یک کد مبهم ادغام نکنید.
چکلیست گزارش در پایاننامه
- میزان فقدان برای متغیرها، گروهها و زمانهای اصلی.
- علتهای شناختهشده و تعداد افراد در هر تحلیل.
- مفروضات سازوکار فقدان و دلیل انتخاب روش.
- جزئیات مدل، تنظیمات و تشخیصها در صورت برآورد چندگانه.
- تحلیلهای حساسیت و اینکه نتیجه اصلی چقدر به مفروضات وابسته است.
- محدودیتهای باقیمانده بدون ادعای بازیابی قطعی اطلاعات.
پرسشهای رایج
خانه خالی را صفر بگذاریم؟
فقط اگر صفر واقعاً پاسخ معتبر و ثبتشده است. صفر و «نمیدانیم» مفاهیم متفاوتیاند.
میتوان افراد ناقص را از فایل اصلی حذف کرد؟
نسخه خام را حفظ کنید. انتخاب نمونه تحلیلی باید با دستور، دلیل و گزارش تعدادها قابل بازسازی باشد.
برای بازبینی، فایل بدون شناسه مستقیم، فرهنگ داده، جدول فقدان و توضیح فرایند جمعآوری را آماده کنید. در مشاوره آماری مدیتورها میتوان روش تحلیل و گزارش محدودیتها را با طراحی شما هماهنگ کرد. اگر مشکل اصلی کمبود تعداد نمونه است، راهنمای نرسیدن به حجم نمونه را هم بخوانید.
بازبینی محتوایی: ۱۳ آبان ۱۴۰۵. تصویر اصلی، ترکیببندی مفهومی اختصاصی است؛ نمودارها و مثالهای عددی آموزشیاند و داده واقعی پژوهش یا تصویر مستند یک مؤسسه معرفی نشدهاند.


